前面只得到了 local equilibrium
Lec_06 中最后得到
f1±f=exp(α∑λαQα)⟹f=exp(∑αλαQα)∓11
这是 local equilibrium, λα=λα(x,t) .
∂μsμ=0
一个回答是 entropy 的定义和前面的 entropy 并不相同
S=∫s0
这是 extensive 的 entropy, 在热力学的图景中, 这对应系统之间没有长程的作用
但最大化 s0 只会导出 local equilibrium, 最大化 S 才会导出 global equilibrium
另一个观点即为: 最大化这两个量的约束不同
Understand entropy from micro physics
Boltzmann’s entropy (classical)
一个图景是 BBGKY Hierarchy
考虑整个 ensemble
ξtot=(ξ1I,ξ2I,⋯,ξNI)
引入
F(ξtot,t):prob. for this ensemble to be in state ξtot
则有
∂tF+α∑dtdxαEoM∂xαF+α∑dtdpαEoM∂pαF=0
在 non - interaction 情形, 粒子的坐标, 动量的导数只依赖自己 (xα,pα) , 假设概率有形式
F=α∏F1(ξα,t)
代入上面得到 collision - less Boltzmann Equation 合于
f(ξ,t)=α∑∫ξαδd(ξ−ξα)F1(ξα,t)
当存在 interaction 时, 例如 Vαβ=V(xα−xβ) , 则动量导数也会包含 ∂αVαβ 这些形式
先考虑前 s 个粒子, 则
Fs(ξ1,⋯,ξs,t)=(α=s+1∏N∫ξα)F
得到 Fs 满足的方程
∂t∂Fs+α=1∑sdtdxαEoM∂xαFs+α=1∑sdtdpαEoM+β=1,β=α∑s(−∂xα∂Vαβ)∂pαFs=α=1∑s∫ξs+1(N−s)∂xα∂Vα,s+1⋅∂pαFs+1
最后把其他粒子的指标换成了同一个指标
即研究 Fs 的演化, 需要知道 Fs+1 , 对于 Boltzmann Equation, 需要 F1
Truncation assumption
一种方式是取 F2(ξ1,ξ2,t)=F1(ξ1,t)F1(ξ2,t) 且不影响我们感兴趣的观测量
一个问题是: 这种假设在多长时间内成立
Important to know how this gives B.E. and how long this assumption remains self - consistent
Gerd 1940s
Last year , proved how long this stays self - consistent (open system, closed system)
即对 entropy 的研究即为研究上面的 assumption 到底在多长时间内成立
Quantum case (some picture)
对于 quantum collision
W∼∣⟨p1p2∣T∣p3p4⟩∣2
由于这是一个经典概率, 必须做假设:
Assumption
Actually we don’t make such observation. But pretending we have done so does not affect observable of interest
例如: 考虑一个粒子在杂质中的散射 T1 , 假设杂质原子旁边还有一个杂质原子 T2
问题即为, 是否应该考虑干涉?
∣⟨p2∣T1∣p1⟩∣2+∣⟨p2∣T2∣p1⟩∣2or∣⟨p2∣(T1+T2)∣p1⟩∣2
如果粒子的波包足够小, 或者原子之间足够远时可以用前者, 即 Boltzmann Eq. 的保证, 即
de Broglie<separation of impurities
这是不平凡的
Understand entropy from statistics without physics
Jaynes’ MaxEnt Principle (Brandeis summer school)
一个例子: 扔骰子, 扔出数字的 average 是 3.5
但我们看到了 average 为 4 , nonuniform 的 distribution 的概率应该长成什么样子?
考虑两个情形
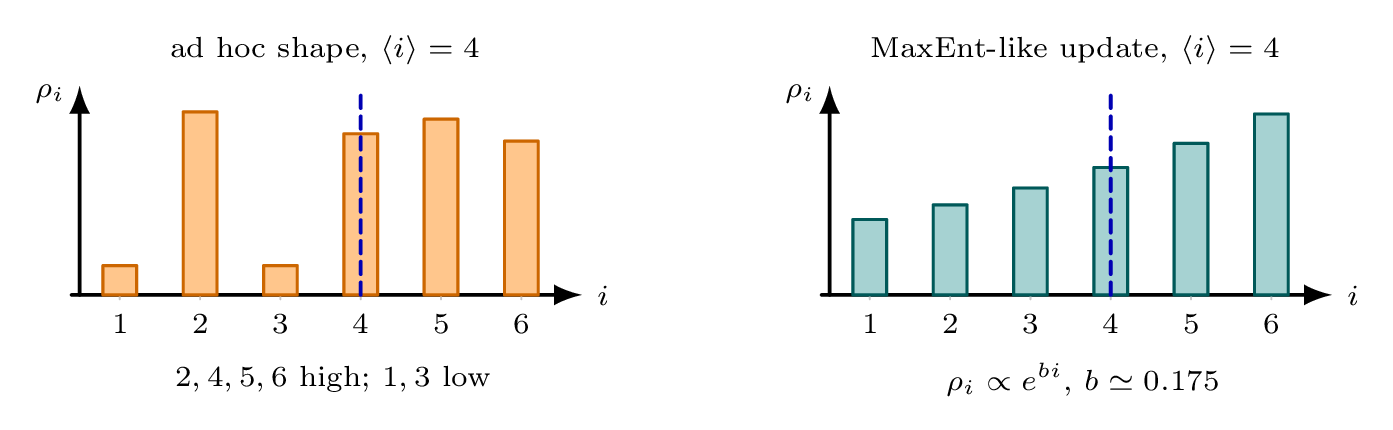
两张图都满足 ⟨i⟩=4。左边只是人为塞进一个满足约束的形状;右边则是在 uniform prior 下由单个平均值约束给出的指数倾斜,因而更像 MaxEnt 会选出的分布。
看起来第二个分布更靠谱, 从一种意义上说 , 看起来最 make sense 的分布可能就是 Boltzmann 分布
现在尝试导出它: 考虑分布 pi , 先考虑 pi=1/6 , 现在扔 N 次骰子 (N≫1)
观察到第 i 个点的次数是 ni , 现在只知道计算出的 ⟨i⟩=4
P{pi}({ni})=i∏pini∏ini!N!
即
lnP≃i∑nilnpi+NlnN−i∑nilnni=−Ni∑ρiln(ρi/pi)<0,ρi=ni/N
那么最大化 P , 得到 P=1pi=ρi (law of large numbers)
但上面是自由约束, 现在需要加上 ⟨i⟩=4 的约束,即 ∑iρii=4
这个过程由 Lagrange multiplier 完成, 得到
ρi=piexp(b⋅i+c)
若 pi 是 uniform , 则直接得到 Boltzmann 分布
可以看到
lnP=−N⋅(relative entropy/K-L divergence)
即
p:original beliefρ:update belief
用更 Bayesian 的观点
P(ρ∣⟨i⟩,p)=P(⟨i⟩∣p)P(⟨i⟩∣ρ,p)P(ρ∣p)
若 i 被替换为连续变量 x , relative entropy 给出
relative entropy=∫dxρ(x)ln(ρ(x)/p(x))
对比
entropy=−∫dxρ(x)lnρ(x)
即对于 entropy , 在连续变量情形, 到底什么是 uniform 是 ambiguous 的
| Dice tossing model | Statistical mechanics |
|---|
| N tosses | The whole system consists of N small subsystems |
| average outcome × N | Total energy (or other extensive quantities) |
| outcome of each toss | Energy of each small subsystem |
| independent tosses, uniform dist. | Assumption of equal a priori probability |
| 前者是纯人类脑子中的假设, 但是后者的等概率假设是需要一个物理上的真实的结果的 | |
最后回到, 为什么local entropy 和 global entropy 的 maximize 的结果不同, 从 Bayesian 的结果看, 两者的 P(ρ∣p) 是相同的, 但是 P(⟨i⟩∣ρ,p) 对于两者方式的约束量是不同的, 前者是 local energy , 后者是 global energy. 这也就导致了最后的结果不同